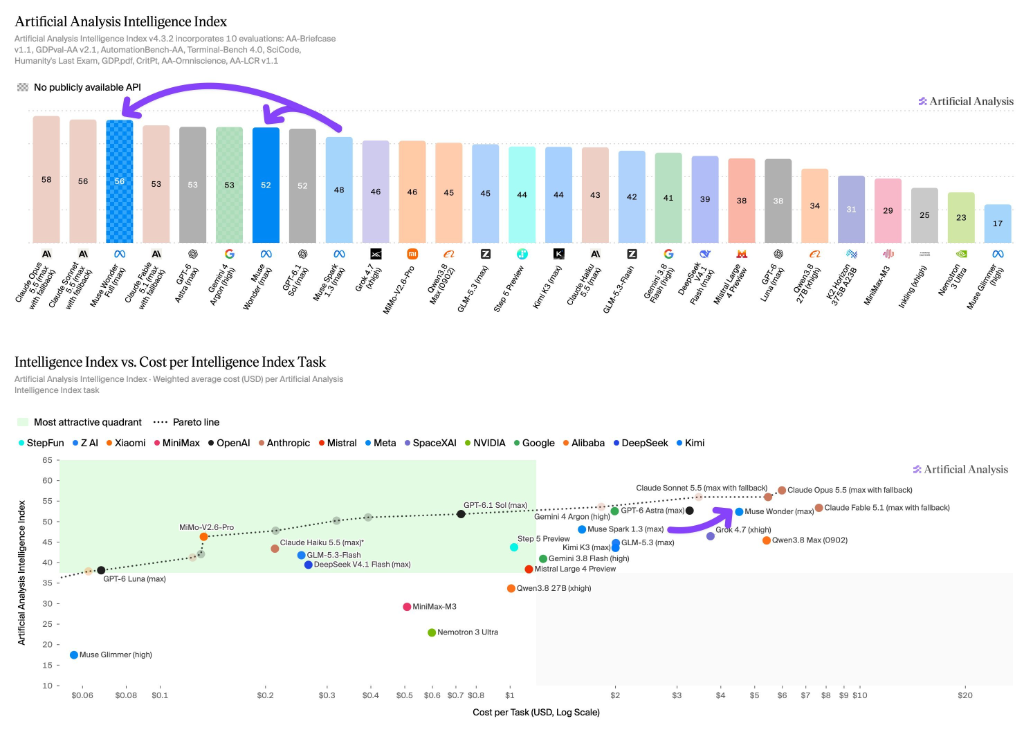
El laboratorio de inteligencia artificial de Meta ha dado un golpe de autoridad en la tabla de evaluación internacional de Artificial Analysis (v4.3.2) con el despliegue de Muse Wonder (max) y los registros preliminares de su variante más densa, Muse Wonder Full (max).
Tras la consolidación de Muse Spark 1.3 (max) como una de las alternativas más eficientes en la franja media-alta de la inferencia corporativa (índice 48), la llegada de la arquitectura Wonder desplaza el equilibrio de poder en los bancos de pruebas de codificación de largo alcance (long-horizon coding) y agentes de trabajo profesional, desafiando frontalmente el dominio que hasta ahora ejercían Claude Opus 5.5, GPT-6 Astra y Claude Sonnet 5.5.
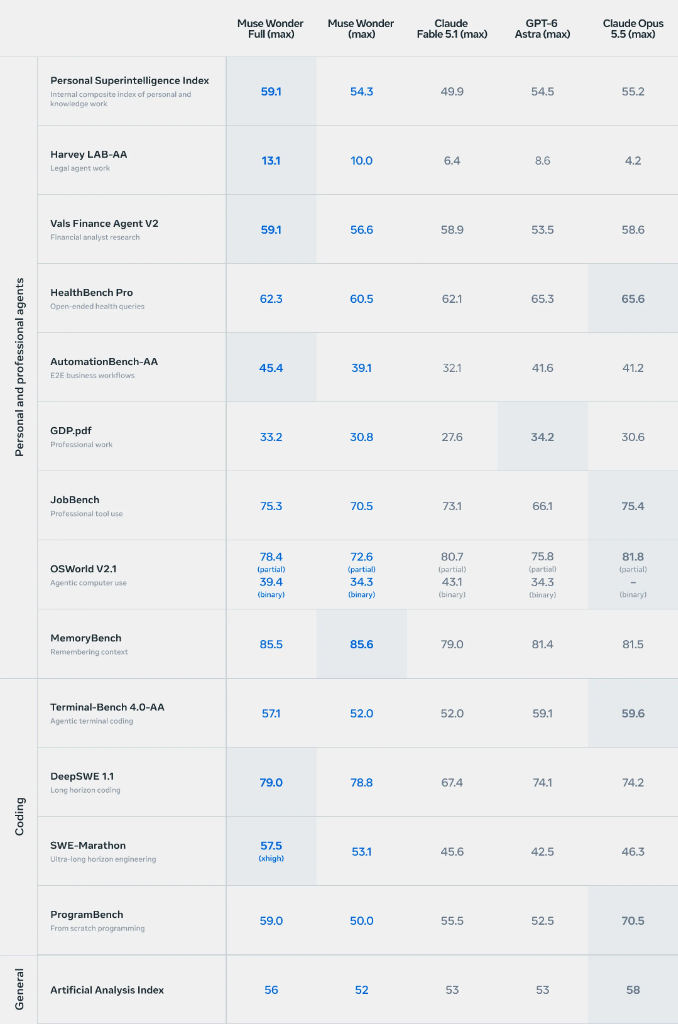
Los datos de la última evaluación consolidada muestran un salto cuantitativo: un ascenso directo de 4 a 8 puntos en el índice global de inteligencia y un dominio abrumador en los benchmarks de ingeniería de software autónoma DeepSWE 1.1 y SWE-Marathon, superando en este último por más de diez puntos porcentuales a los buques insignia de OpenAI y Anthropic.
1. El Salto Generacional: De Muse Spark 1.3 a la Ruptura con Muse Wonder
La familia Muse de Meta ha estructurado su catálogo a lo largo de 2026 en torno a tres escalones de cómputo y especialización: Muse Glimmer (modelos de baja latencia con índice 17), Muse Spark (el caballo de batalla equilibrado para producción) y la nueva frontera Muse Wonder.
En la actualización v4.3.2 de Artificial Analysis, la evolución representada por la transición entre Spark y Wonder marca un cambio de filosofía en Meta:
- Muse Spark 1.3 (max): Situado con un índice global de 48, se consolidó como una solución de alto rendimiento a un coste medio ponderado de ~2,40 USD por tarea, compitiendo directamente con Grok 4.7 (46), MiMo-V2.6-Pro (46) y Qwen3.8 Max (45).
- Muse Wonder (max): Con un índice de 52, escala directamente al grupo de cabeza, empatando con GPT-6.1 Sol (52) y situándose a solo un punto de gigantes como GPT-6 Astra (53), Gemini 4 Argon (53) y Claude Fable 5.1 (53). Este incremento conlleva un coste medio de ~4,50 USD por tarea, manteniéndose por debajo de los costes de Claude Opus 5.5 (~6,50 USD) y Claude Fable 5.1 (~8,00 USD).
- Muse Wonder Full (max): La configuración de máxima capacidad alcanza un índice de 56, igualando el registro de Claude Sonnet 5.5 y dejando atrás a Astra, Fable 5.1 y Argon. En la clasificación general del índice, únicamente Claude Opus 5.5 (58) retiene una puntuación superior.
Esta progresión sitúa a Meta no como un competidor reactivo que replica los pesos de sus rivales, sino como el nuevo estándar en flujos de razonamiento continuado y resolución de incidencias en código base masivo.
2. Radiografía de Artificial Analysis v4.3.2: Índices y Cuadrante de Coste
El índice compuesto de Artificial Analysis v4.3.2 unifica diez entornos de evaluación rigurosos: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience y AA-LCR v1.1.
La posición de los principales modelos en la tabla oficial queda configurada de la siguiente manera:
| Modelo | Desarrollador | Índice Global AA | Coste Ponderado / Tarea | Estado de API |
|---|---|---|---|---|
| Claude Opus 5.5 (max) | Anthropic | 58 | ~6,50 USD | Disponible |
| Claude Sonnet 5.5 (max) | Anthropic | 56 | ~3,50 USD | Disponible |
| Muse Wonder Full (max) | Meta | 56 | En evaluación interna | Sin API pública |
| Claude Fable 5.1 (max) | Anthropic | 53 | ~8,00 USD | Disponible |
| GPT-6 Astra (max) | OpenAI | 53 | ~3,00 USD | Disponible |
| Gemini 4 Argon (high) | 53 | ~4,00 USD | Disponible | |
| Muse Wonder (max) | Meta | 52 | ~4,50 USD | Disponible |
| GPT-6.1 Sol (max) | OpenAI | 52 | ~1,30 USD | Frontera Pareto |
| Muse Spark 1.3 (max) | Meta | 48 | ~2,40 USD | Disponible |
| Grok 4.7 (xhigh) | SpaceXAI | 46 | ~3,80 USD | Disponible |
| MiMo-V2.6-Pro | Xiaomi | 46 | ~0,13 USD | Frontera Pareto |
| Qwen3.8 Max (0902) | Alibaba | 45 | ~5,00 USD | Disponible |
| GLM-5.3 (max) | Z.ai | 45 | ~2,20 USD | Disponible |
| Step 5 Preview | StepFun | 44 | ~1,10 USD | Disponible |
| Kimi K3 (max) | Moonshot | 44 | ~1,40 USD | Disponible |
| Claude Haiku 5.5 (max) | Anthropic | 43 | ~0,25 USD | Frontera Pareto |
En el análisis de la curva de Pareto de coste versus inteligencia, Muse Wonder (max) se sitúa en una posición estratégica: ofrece una alternativa directa a los modelos con mayor razonamiento sintético sin disparar los costes a las cotas de Claude Fable 5.1, sirviendo de puente para organizaciones que requieren razonamiento de grado frontera sin asumir sobrecostes de inferencia extrema.
3. Liderazgo en Ingeniería de Software: DeepSWE 1.1 y SWE-Marathon
El apartado donde la familia Muse Wonder marca una distancia crítica respecto a toda la industria es la ingeniería de software agéntica y la resolución de problemas de horizonte temporal extendido (ultra-long horizon engineering).
DeepSWE 1.1: Resolución de Bugs Reales en Repositorios
En el banco de pruebas DeepSWE 1.1, que somete a los modelos a la resolución de pull requests y bugs reales en repositorios complejos de código abierto:
- Muse Wonder Full (max) lidera con un 79,0%.
- Muse Wonder (max) alcanza un 78,8%.
- Claude Opus 5.5 (max) queda en un 74,2%.
- GPT-6 Astra (max) registra un 74,1%.
- Claude Fable 5.1 (max) se queda rezagado con un 67,4%.
La consistencia entre la versión Full y la versión estándar de Wonder (79,0% vs 78,8%) demuestra que la capacidad de diagnóstico y corrección de código no depende exclusivamente del escalado masivo de parámetros o sobre-muestreo, sino de un refinamiento algorítmico en el rastreo del árbol de dependencias y la sintaxis cruzada.
SWE-Marathon: La Prueba de Resistencia Agéntica
Donde la diferencia se convierte en una brecha categórica es en SWE-Marathon, una batería de evaluaciones diseñada para medir si un agente es capaz de mantener el contexto, la consistencia lógica y la coherencia arquitectónica durante sesiones de trabajo que abarcan cientos de pasos continuos:
- Muse Wonder Full (max): 57,5% (xhigh).
- Muse Wonder (max): 53,1%.
- Claude Opus 5.5 (max): 46,3%.
- Claude Fable 5.1 (max): 45,6%.
- GPT-6 Astra (max): 42,5%.
Muse Wonder supera por 11,2 puntos porcentuales a Claude Opus 5.5 y por 15 puntos a GPT-6 Astra. En flujos de refactorización donde modelos anteriores colapsaban por deriva contextual o bucles de auto-corrección destructiva, la arquitectura de Meta mantiene la estabilidad de la sesión completa.
Solo en ProgramBench (programación desde cero en entornos aislados) Claude Opus 5.5 mantiene la delantera con un 70,5% frente al 59,0% de Wonder Full y el 50,0% de Wonder, lo que evidencia que la fortaleza de Muse radica en el análisis de código vivo preexistente y no en la generación sintética en hoja en blanco.
4. Agentes Profesionales, Memoria de Trabajo y Computer Use
Más allá de la programación pura, la tabla comparativa revela un rendimiento destacado en tareas analíticas verticales y retención de memoria:
Harvey LAB-AA: Especialización Legal Agéntica
En flujos de análisis de contratos, detección de cláusulas nulas y jurisprudencia corporativa (Harvey LAB-AA):
- Muse Wonder Full: 13,1 puntos.
- Muse Wonder: 10,0 puntos.
- GPT-6 Astra: 8,6 puntos.
- Claude Fable 5.1: 6,4 puntos.
- Claude Opus 5.5: 4,2 puntos.
Muse Wonder triplica el rendimiento del buque insignia de Anthropic en razonamiento jurídico, un área donde Claude tradicionalmente ostentaba una reputación consolidada.
Vals Finance Agent V2: Modelado Financiero
En investigación cuantitativa y análisis de informes contables complejos:
- Muse Wonder Full: 59,1.
- Claude Fable 5.1: 58,9.
- Claude Opus 5.5: 58,6.
- Muse Wonder: 56,6.
- GPT-6 Astra: 53,5.
MemoryBench: Retención de Contexto Operativo
En MemoryBench, métrica que mide la capacidad del modelo para recordar hechos y directivas inyectadas en etapas tempranas de ventanas de contexto prolongadas:
- Muse Wonder (max): 85,6%.
- Muse Wonder Full (max): 85,5%.
- Claude Opus 5.5: 81,5%.
- GPT-6 Astra: 81,4%.
- Claude Fable 5.1: 79,0%.
Wonder supera la barrera del 85%, reduciendo las alucinaciones por desbordamiento contextual y garantizando la fidelidad a directivas complejas de sistema.
OSWorld V2.1: Uso Autónomo del Sistema Operativo
En el test agéntico de interacción con interfaces de usuario y navegación por escritorio (OSWorld V2.1), los resultados muestran un comportamiento competitivo:
- En métrica parcial: Claude Opus 5.5 lidera con 81,8%, seguido de Claude Fable 5.1 (80,7%), Muse Wonder Full (78,4%), GPT-6 Astra (75,8%) y Muse Wonder (72,6%).
- En evaluación binaria estricta (task completion sin asistencia): Claude Fable 5.1 alcanza un 43,1%, Muse Wonder Full anota un 39,4% y Muse Wonder empata con GPT-6 Astra en un 34,3%.
5. La Incógnita de Muse Wonder Full: ¿Por Qué Meta Mantiene Cerrada su Joya de 56 Puntos?
En los gráficos de Artificial Analysis, Muse Wonder Full aparece acompañado de una anotación técnica determinante: No publicly available API (sin API pública disponible).
Esta distinción explica la doble presencia de la marca Wonder en el mercado:
- Muse Wonder (max) (Índice 52): Es el modelo actualmente operativo en entornos de producción y plataformas asociadas, dimensionado para ofrecer un ratio coste/rendimiento sostenible en cargas de trabajo de escala empresarial (~4,50 USD por tarea).
- Muse Wonder Full (max) (Índice 56): Representa el modelo completo sin técnicas agresivas de compresión o cuantización intermedia. Su consumo de recursos computacionales por token generado lo restringe de momento a laboratorios de investigación interna y bancos de pruebas cerrados de evaluación.
El precedente de OpenAI con la contención de Astra tras detectar anomalías en la interacción agéntica pone de relieve que los laboratorios de frontera están adoptando un enfoque más prudente antes de habilitar llamadas masivas de API a modelos que superan el 75% en DeepSWE o el 55% en SWE-Marathon.
6. Ecosistema de Despliegue Agéntico y Arquitectura de Ejecución
El auge de modelos como Muse Wonder, capaces de encadenar decenas de llamadas a terminales, compiladores e inspecciones de estado, confirma que el valor de la inteligencia artificial ya no reside en el chat conversacional simple, sino en la ejecución de procesos desatendidos.
Para equipos de desarrollo y consultoras de software que despliegan agentes autónomos 24/7 en local o en edge, el cuello de botella se traslada a la estabilidad de los entornos de ejecución: orquestar contenedores Docker, coordinar microservidores de terminales y validar sintaxis en tiempo real exige una infraestructura dedicada y siempre activa.
En este tipo de arquitecturas, los desarrolladores delegan las tareas macro a las APIs de modelos de frontera (como Muse Wonder o Claude Opus 5.5) mientras mantienen micro-servidores físicos de bajo consumo (como placas Raspberry Pi 5 o clústeres locales de subagentes) ejecutando listeners en Python y flujos de integración continua sin depender de instancias cloud costosas en reposo.
7. Preguntas Frecuentes sobre Muse Wonder y Muse Spark
¿Qué diferencia principal existe entre Muse Spark 1.3 y Muse Wonder?
Muse Spark 1.3 está diseñado como un modelo de producción equilibrado con un índice de 48 y un coste medio de ~2,40 USD por tarea, orientado a tareas habituales de desarrollo y análisis. Muse Wonder es un modelo de frontera con un índice de 52 (y hasta 56 en la versión Full), optimizado específicamente para ingeniería de software compleja, memoria de largo alcance y flujos agénticos donde supera holgadamente a Spark a cambio de un mayor consumo computacional (~4,50 USD por tarea).
¿En qué bancos de pruebas supera Muse Wonder a Claude Opus 5.5 y GPT-6 Astra?
Muse Wonder (y especialmente su versión Full) lidera con claridad en DeepSWE 1.1 (79,0% frente al 74,2% de Opus 5.5 y 74,1% de Astra), en SWE-Marathon (57,5% frente a 46,3% de Opus y 42,5% de Astra), en Harvey LAB-AA para trabajo legal (13,1 frente a 4,2 de Opus) y en MemoryBench para retención de directivas (85,6% frente a 81,5% de Opus).
¿Cuándo estará disponible la API de Muse Wonder Full?
Actualmente, Meta mantiene la versión Muse Wonder Full (índice 56) restringida a pruebas internas y evaluaciones de seguridad en Artificial Analysis. La versión con disponibilidad de acceso para desarrolladores y empresas es Muse Wonder (max) (índice 52).
¿Cuál es el coste por tarea de Muse Wonder frente a sus competidores directos?
Muse Wonder (max) se sitúa en una media ponderada de ~4,50 USD por tarea en Artificial Analysis. Esto lo posiciona por debajo de Claude Opus 5.5 (~6,50 USD) y Claude Fable 5.1 (~8,00 USD), aunque por encima de modelos como GPT-6.1 Sol (~1,30 USD) o Muse Spark 1.3 (~2,40 USD).
¿Cómo se comporta Muse Wonder en tareas de uso del sistema operativo (Computer Use)?
En el benchmark OSWorld V2.1, Muse Wonder Full alcanza un 78,4% en evaluación parcial y un 39,4% en evaluación binaria sin asistencia humana, ubicándose inmediatamente detrás de Claude Opus 5.5 (81,8%) y Claude Fable 5.1 (80,7% / 43,1%), y superando a GPT-6 Astra en la tasa de compleción directa.