La reciente publicación de los registros de Artificial Analysis (v4.3.2) coronó a Muse Wonder y Muse Wonder Full de Meta como los nuevos reyes de la ingeniería de software agéntica, presumiendo de un 79,0% en DeepSWE 1.1 y un 57,5% en SWE-Marathon, superando a Claude Opus 5.5 y GPT-6 Astra.
Sin embargo, las primeras pruebas de campo independientes en entornos de producción y generación de código en vivo han destapado una realidad radicalmente distinta: Muse Wonder es un caso paradigmático de benchmaxing.
Mientras que en las tablas oficiales los modelos de Meta aparentan haber desbancado a Anthropic, someter a Muse Wonder a proyectos reales de arquitectura compleja, motores gráficos WebGL, shaders GLSL y simulaciones Three.js revela un colapso estrepitoso: código simplón, modelos 3D primitivos de nivel amateur y una incapacidad manifiesta para razonar espacialmente frente a la sofisticación técnica de Claude Opus 5.5 o SWE 2.
1. ¿Qué es el Benchmaxing y Cómo se Aplica la Ley de Goodhart en IA?
En la comunidad de ingeniería de modelos fundacionales, el término benchmaxing define la práctica de sobre-optimizar o sobreajustar (overfitting) los pesos y las políticas de alineamiento de un modelo de lenguaje para maximizar su puntuación en bancos de pruebas estandarizados y públicos, descuidando o sacrificando deliberadamente su competencia en el mundo real.
Este fenómeno es la plasmación matemática de la Ley de Goodhart:
"Cuando una métrica se convierte en un objetivo, deja de ser una buena métrica."
Durante los últimos dos años, suites como SWE-bench, SWE-Marathon y DeepSWE se convirtieron en el estándar de oro para medir la capacidad de un modelo de actuar como un ingeniero de software autónomo. Los laboratorios comenzaron a utilizar estos entornos como funciones de recompensa en sus algoritmos de aprendizaje por refuerzo (RL con retroalimentación de compilador y terminal).
El resultado directo es la aparición de modelos "estudiantes de diez en exámenes tipo test": saben exactamente qué atajos sintácticos tomar para que un validador automático devuelva un código de salida 0, pero carecen de la comprensión conceptual necesaria para programar una aplicación coherente desde cero.
2. La Trampa de DeepSWE: Pasar Tests Unitarios no es Crear Software
Para entender por qué Muse Wonder lidera las tablas pero fracasa en pantalla, es imprescindible diseccionar cómo se evalúa un benchmark como DeepSWE 1.1:
- Contexto cerrado y preexistente: El modelo recibe un repositorio abierto maduro (como Django, SymPy o Matplotlib) junto con la descripción de una incidencia (issue) de GitHub.
- Intervención microscópica: El objetivo del agente no es crear software, sino emitir un parche (
git diff) que suele oscilar entre 5 y 30 líneas de código para aislar una regresión. - Criterio binario de éxito: Un script de automatización ejecuta
pytesto la suite de pruebas unitarias asociada. Si todas las aserciones pasan en verde, la tarea se computa como un éxito absoluto (100%).
Esta metodología premia la cirugía de parches sintácticos:
- No evalúa la coherencia estética de una interfaz.
- No mide si la arquitectura modular es escalable o mantenible.
- No detecta si el rendimiento en tiempo real a 60 FPS colapsa por fugas de memoria o mala gestión de buffers gráficos.
- Ignora por completo el razonamiento espacial, la trigonometría tridimensional y la experiencia de usuario.
Meta entrenó a la familia Muse Wonder para ser un cirujano implacable de aserciones unitarias en Python y scripts de servidor. Pero cuando ese mismo modelo se enfrenta a una hoja en blanco y se le pide diseñar un entorno interactivo completo, la ilusión algorítmica se desvanece.
3. Greenfield vs. Brownfield: La Pista Oculta de ProgramBench
En nuestro análisis previo de las especificaciones oficiales de Artificial Analysis, una métrica ya alertaba de esta asimetría estructural:
- En SWE-Marathon (reparación continuada de bugs en repositorios preexistentes), Muse Wonder Full marcó un 57,5%, aventajando por más de 11 puntos a Claude Opus 5.5 (46,3%).
- En ProgramBench (generación completa de software desde cero en entornos aislados o greenfield), la situación se invirtió por completo: Claude Opus 5.5 dominó con un 70,5%, mientras que Muse Wonder Full se desplomó al 59,0% y Muse Wonder estándar cayó a un mediocre 50,0%.
Cuando a Muse Wonder se le retira la "muleta" de un repositorio ya estructurado por ingenieros humanos y se le exige concebir la arquitectura, los bucles de renderizado y el estado de la aplicación desde una hoja en blanco, el modelo evidencia su incapacidad para planificar sistemas complejos.
4. La Evidencia Visual: Comparativas de Campo Frente a Opus 5.5 y SWE 2
Las pruebas realizadas por la comunidad de desarrolladores comparando prompts idénticos de desarrollo interactivo demuestran la abismal brecha de calidad entre la puntuación teórica y la ejecución tangible.
Caso 1: Clon de Voxel Engine / Minecraft
En una prueba directa solicitando un clon jugable de Minecraft en WebGL con generación procedural de terreno y ciclo de iluminación:
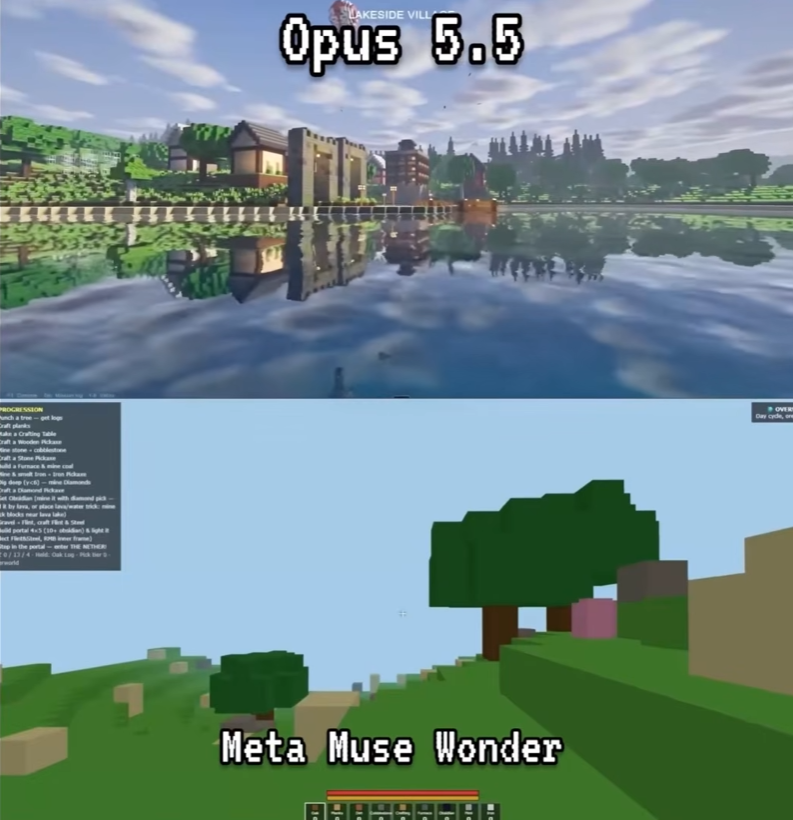
- Claude Opus 5.5 (Arriba): Implementa un pipeline tridimensional avanzado. Genera agua volumétrica con shaders de reflexión especular, refracción en tiempo real, nubes volumétricas, ciclo circadiano dinámico, sombras suaves y una distancia de dibujado optimizada con mallas instanciadas (instanced meshes). La escena parece un motor gráfico comercial.
- Meta Muse Wonder (Abajo): Entrega un prototipo plano y tosco. Bloques lisos sin filtrado ni textura, un árbol formado por tres cubos verdes sin sombreado, modelos animales geométricos elementales y un plano de césped uniforme sin relieve ni iluminación física. El resultado recuerda a los primeros experimentos caseros de voxel de hace más de una década.
Caso 2: Lawnmower Simulator y la Realidad de la Factura de Inferencia
En el diseño de un simulador mecánico en primera persona ("Lawn Mower Simulator en una finca señorial"), la comparativa visual viene acompañada de un dato financiero revelador:
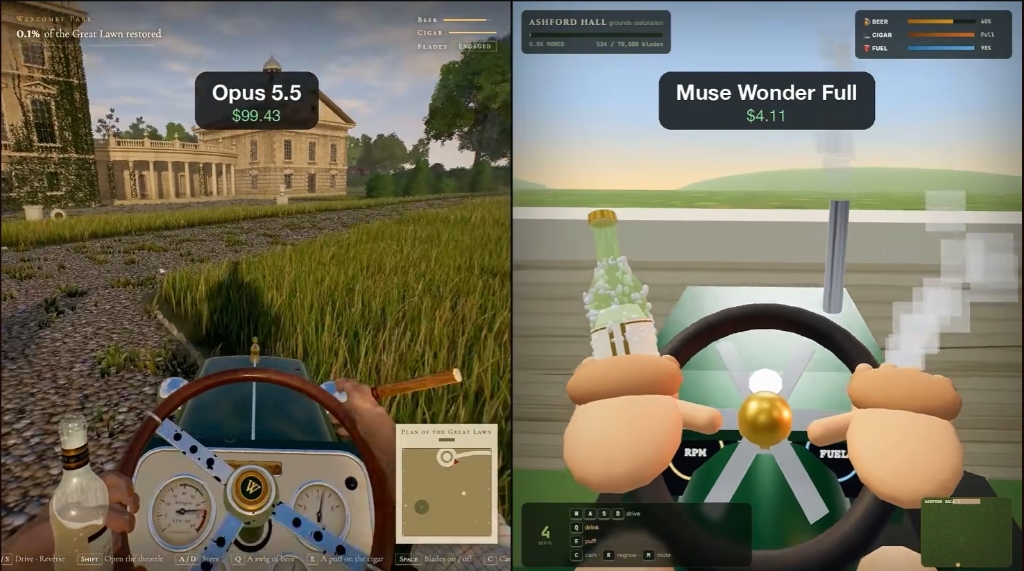
- Claude Opus 5.5 (Izquierda - $99,43 de cómputo): Desarrolló un entorno con hierba densa individual, la fachada de una mansión señorial inglesa con arquitectura renacentista, un tractor de época modelado al detalle con volante de cuero, instrumentación analógica de latón funcional (tacómetro, velocímetro, aguja de combustible), minimapa en tiempo real y física inmersiva de conducción. El coste de la sesión alcanzó casi los 100 dólares debido al ingente volumen de tokens de razonamiento interno (extended thinking), cálculo matricial y miles de líneas de WebGL generadas.
- Muse Wonder Full (Derecha - $4,11 de cómputo): Generó una caricatura low-poly. Las manos del conductor son cilindros de dibujo animado sin articulaciones, la botella de cerveza es una masa poligonal básica, el tractor se compone de cajas sin biselar y el humo son partículas cuadradas estáticas. Costó únicamente 4,11 dólares.
Este contraste desmitifica la supuesta "eficiencia milagrosa" de Meta. Muse Wonder no es más barato porque descubrió una optimización matemática revolucionaria; es más barato porque recorta drásticamente el presupuesto de inferencia, entregando la solución más simplona y superficial posible que no lance un error de compilación.
Caso 3: Living Koi Pond (Three.js y Simulación Orgánica)
En el reto de crear un estanque zen interactivo con carpas koi nadando bajo la superficie, interactuando con alimento y follaje:
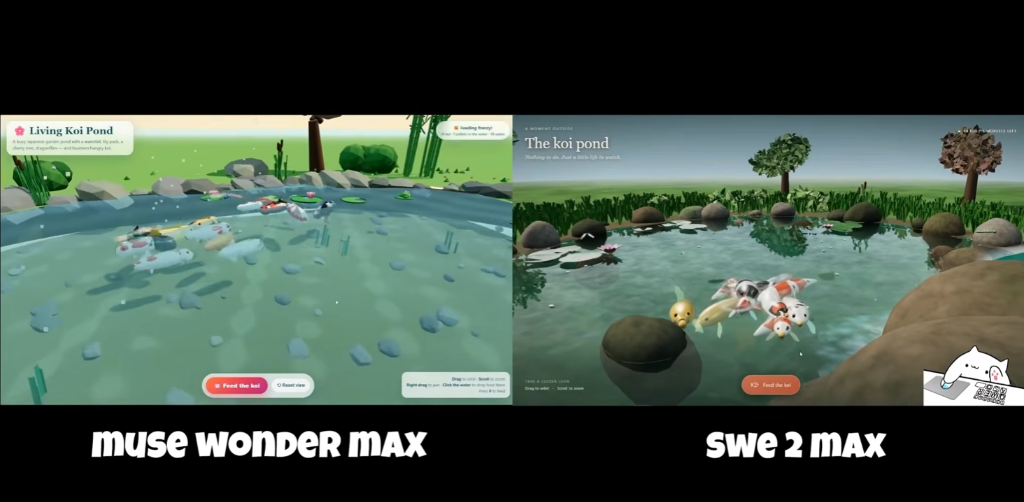
- SWE 2 MAX (Derecha): Modela cáusticas de agua en tiempo real, reflejos de cielo, piedras con textura orgánica y variaciones de luz difusa, nenúfares flotantes con sombreado natural y modelos de peces koi que flexionan su espina dorsal con cinemática procedural al nadar.
- Muse Wonder Max (Izquierda): Crea un estanque infantil con agua de color pastel sólido, rocas de baja resolución dispersas aleatoriamente, bambú esquemático y peces que consisten en elipsoides rígidos que flotan en línea recta. Carece de la menor noción de dinámica de fluidos o física de superficies.
5. La Brecha de Entrenamiento: Razonamiento Gráfico y Matemáticas Espaciales
¿Por qué los modelos de Anthropic (Opus 5.5, Sonnet 5.5) y agentes especializados como SWE 2 sobresalen donde Muse Wonder se estrella?
- Preentrenamiento en Shaders y Motores de Render: Claude Opus ha sido expuesto masivamente a código fuente de Three.js, Babylon.js, WebGPU, librerías de matemáticas 3D (gl-matrix) y programación de shaders en GLSL/HLSL. Comprende los conceptos de cálculo vectorial, productos escalares para iluminación Lambertiana y matrices de transformación de perspectiva.
- Profundidad de Ventana de Pensamiento: Cuando Claude Opus 5.5 aborda una aplicación gráfica, no empieza tirando líneas de código reactivas; planifica la arquitectura de la escena: qué geometrías compartir mediante
InstancedMesh, cómo estructurar el buclerequestAnimationFramey cómo separar la física de la renderización. - Poda Agresiva en Meta: Para conseguir que Muse Wonder funcione a un coste medio de ~4,50 USD por tarea empresarial, Meta aplicó técnicas severas de cuantización y destilación guiadas por benchmarks de texto y scripts backend. En el proceso de poda, el conocimiento latente sobre gráficos, coherencia visual y estética frontend fue prácticamente erradicado.
6. Lecciones para Desarrolladores: Cómo Evaluar un Modelo Más Allá del Marketing
El caso de Muse Wonder debe servir como una llamada de atención para directores de tecnología, ingenieros de software e inversores en IA:
- Desconfía de los benchmarks unitarios puros: Un modelo con un 80% en DeepSWE puede ser extraordinario para corregir un bug tonto en una librería legacy de Python, pero absolutamente inútil para construir una startup, una interfaz moderna o un producto digital de consumo.
- La trampa del coste por token: Un modelo que cuesta 4 dólares pero genera basura que un equipo senior debe reescribir desde cero cuesta, en realidad, miles de dólares en tiempo humano desperdiciado. Un modelo de 99 dólares como Opus 5.5 que entrega un sistema funcional de alta fidelidad genera un retorno de inversión inmediato.
- Exige pruebas de campo "Greenfield": Antes de adoptar un proveedor de inferencia corporativo, somete al modelo a pruebas ciegas de creación completa de aplicaciones (WebGL, React con Tailwind, orquestación de APIs externas), no a tests automáticos de selección múltiple.
7. Preguntas Frecuentes sobre Benchmaxing y Muse Wonder
¿Qué significa exactamente el término benchmaxing en inteligencia artificial?
El benchmaxing describe la práctica de optimizar un modelo de lenguaje de forma desproporcionada para maximizar sus puntuaciones en tablas de evaluación públicas (como SWE-bench o Artificial Analysis), habitualmente mediante aprendizaje por refuerzo sobre problemas muy similares a las pruebas, lo que provoca que su rendimiento en tareas reales y diversas sea muy inferior al publicitado.
¿Por qué Muse Wonder saca 79% en DeepSWE si luego genera gráficos tan malos?
Porque DeepSWE y SWE-bench evalúan únicamente si el modelo es capaz de reparar pequeños fallos en repositorios de código preexistentes para que los tests unitarios pasen. No miden el diseño visual, la arquitectura general, el renderizado 3D ni la capacidad de construir una aplicación compleja desde una hoja en blanco.
¿Por qué Claude Opus 5.5 es tan superior a Muse Wonder en proyectos de software completos?
Claude Opus 5.5 cuenta con una base de preentrenamiento mucho más densa en matemáticas espaciales, shaders GLSL y arquitectura de software, además de un presupuesto de inferencia y razonamiento interno muy superior. Esto le permite concebir sistemas visuales y mecánicos fotorrealistas en lugar de prototipos geométricos básicos.
¿Es Muse Wonder inútil para cualquier tarea técnica?
No necesariamente. Para tareas estrictamente backend, parches menores de sintaxis en repositorios corporativos de Python o automatización de scripts CLI donde no intervenga la creatividad ni la interfaz gráfica, Muse Wonder puede ser una herramienta económica. Sin embargo, no está a la altura de la categoría de frontera que sus benchmarks aparentaban reflejar.