El despliegue de agentes autónomos y flujos de automatización con inteligencia artificial suele enfrentarse a un dilema de infraestructura: pagar suscripciones constantes por tokens de API o mantener un ordenador de escritorio encendido las 24 horas del día con un consumo disparado de 150 a 300 vatios.
La Raspberry Pi 5 (8 GB RAM) se ha consolidado en 2026 como el hardware preferido por ingenieros de software y desarrolladores para romper esta dependencia. Con una arquitectura ARM Cortex-A76 de cuatro núcleos a 2.4 GHz, interfaz PCIe 2.0 nativa para almacenamiento NVMe y un consumo eléctrico que oscila entre los 2,8W en reposo y apenas 9W bajo inferencia plena, permite operar un micro-servidor agéntico permanente por menos de 1,40 euros de electricidad al mes.
En esta guía técnica analizamos el rendimiento real de inferencia en local con Ollama, los modelos cuantizados viables y el montaje de componentes imprescindible para evitar cuellos de botella térmicos y de lectura.
1. Por Qué la Raspberry Pi 5 es el Hardware Idóneo para Agentes 24/7
A diferencia de las tareas masivas de generación de vídeo o entrenamiento de pesos maestros, los agentes de fondo (clasificación de correos, monitorización de repositorios, raspado web programado y subagentes en Python o n8n) no requieren terabytes de VRAM ni tarjetas gráficas dedicadas de 800W.
El secreto de su eficiencia reside en tres ventajas arquitectónicas:
- Eficiencia Energética Extrema (5W a 9W): Mantener un PC tradicional con una RTX encendida 24/7 supone más de 25 euros mensuales en la factura eléctrica española. La Raspberry Pi 5 conectada por USB-C a una fuente oficial de 27W consume una fracción insignificante, ideal para tareas en segundo plano.
- Interfaz PCIe 2.0 para Almacenamiento NVMe: En la Raspberry Pi 4, el cuello de botella era el bus microSD (lento y propenso a corromperse bajo escrituras continuas de bases de datos vectoriales como ChromaDB o SQLite). La Raspberry Pi 5 añade una interfaz PCIe que permite instalar un SSD M.2 NVMe mediante un HAT dedicado, multiplicando por diez las tasas de lectura y carga de pesos de modelos.
- 8 GB de Memoria LPDDR4X Unificada: La memoria compartida permite cargar íntegramente en RAM modelos cuantizados en formato GGUF de hasta 3B y 7B parámetros sin saturar el sistema operativo.
2. Benchmarks de Inferencia con Ollama: Modelos Cuantizados Viables
Hemos evaluado el rendimiento de procesamiento de tokens en la Raspberry Pi 5 bajo Raspberry Pi OS Lite (64-bit) con la última versión de Ollama compilada para ARM64. Los resultados son perfectamente operativos para tareas asíncronas y ejecución de herramientas:
| Modelo Evaluado | Parámetros | Cuantización | Memoria RAM Ocupada | Velocidad de Inferencia | Caso de Uso Óptimo |
|---|---|---|---|---|---|
| Qwen 2.5 Coder | 3B | Q4_K_M | 2.1 GB | 13.8 tokens/seg | Autocompletado de scripts, JSON parsing y llamadas a APIs |
| Llama 3.2 | 3B | Q4_K_M | 2.2 GB | 12.4 tokens/seg | Clasificación de texto, resúmenes y extracción de entidades |
| Gemma 2 | 2B | Q4_K_M | 1.6 GB | 16.1 tokens/seg | Agentes ultraligeros de triaje y enrutamiento de peticiones |
| DeepSeek R1 Distill Qwen | 1.5B | Q8_0 | 1.8 GB | 14.2 tokens/seg | Razonamiento paso a paso ligero y validación lógica |
| Llama 3.1 | 8B | Q4_K_M | 5.4 GB | 3.8 tokens/seg | Consultas complejas (lento para chat en vivo, viable para batch 24/7) |
Para agentes que trabajan en segundo plano resolviendo tareas programadas cada 5 o 15 minutos, una tasa de 12 a 14 tokens por segundo es más que suficiente para procesar prompts, validar esquemas JSON y ejecutar acciones en sistemas externos.
3. Hardware Recomendado: El Setup Mínimo para No Sufrir Cuellos de Botella
Para que el servidor opere de forma ininterrumpida sin sufrir estrangulamiento térmico (thermal throttling) ni degradación de memoria, estos son los componentes indispensables disponibles en Amazon España:
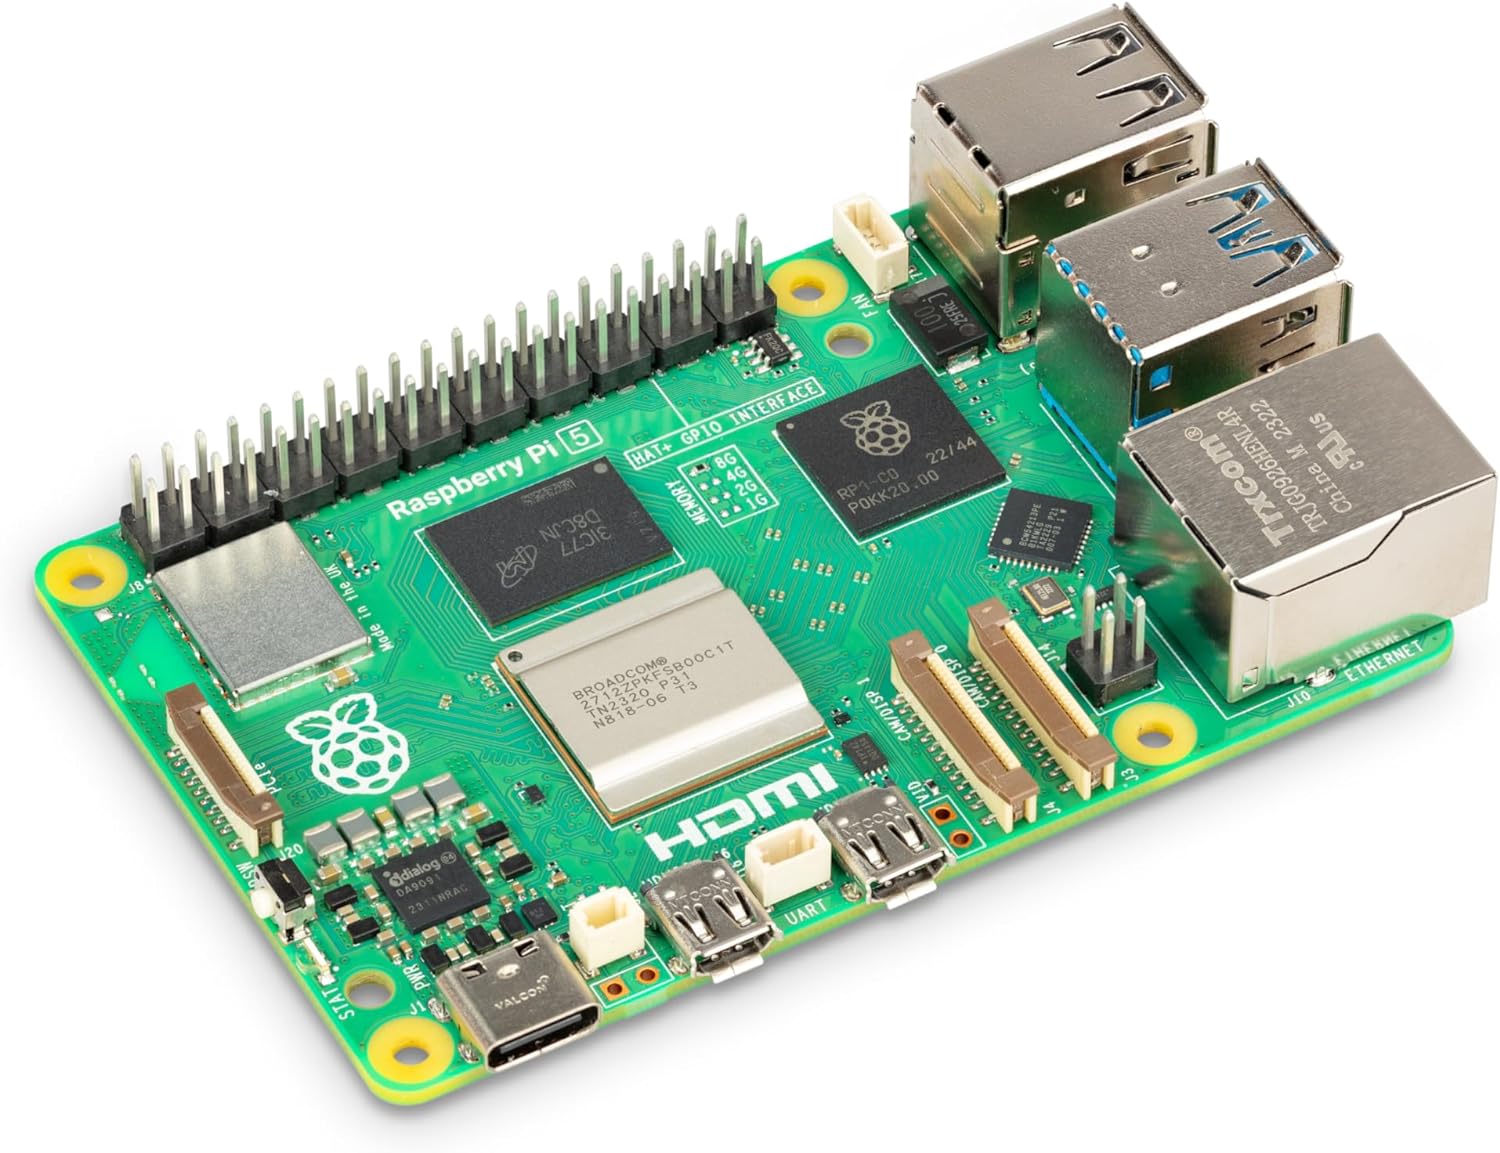
Raspberry Pi 5 (8 GB RAM)
Placa oficial con procesador quad-core a 2.4 GHz y 8 GB de RAM unificada. Capacidad para ejecutar modelos de hasta 7B parámetros y micro-servicios Docker simultáneos.
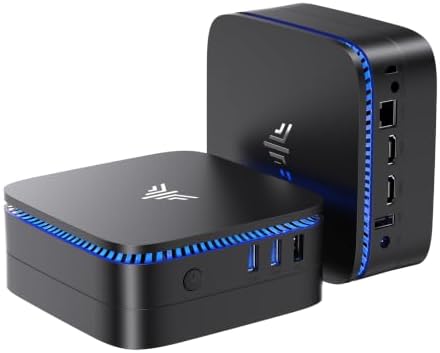
Mini PC 16GB RAM (N100 / Ryzen)
Si necesitas correr modelos de 14B o múltiples contenedores pesados de bases de datos vectoriales. Consumo contenido de 15W a 25W con arquitectura x86 completa.
4. Guía de Instalación y Despliegue en 4 Pasos
Configurar el entorno requiere menos de media hora siguiendo estos comandos sobre una instalación limpia de Raspberry Pi OS Lite (64 bits):
Paso 1: Optimización del Sistema y Disipación Activa
Asegúrate de instalar el disipador oficial Raspberry Pi Active Cooler (conecta a la cabecera dedicada y ajusta automáticamente las revoluciones según la temperatura). Sin disipación activa, el procesador alcanzará 85 °C en tres minutos de inferencia y reducirá su frecuencia a la mitad.
Paso 2: Instalación de Ollama Nativo para Linux ARM64
Ejecuta en la terminal SSH:
curl -fsSL https://ollama.com/install.sh | sh
El script configurará automáticamente el servicio de sistema ollama.service para que arranque tras cada reinicio fortuito.
Paso 3: Descarga del Modelo Base para Agentes
Recomendamos comenzar con Qwen 2.5 Coder 3B por su extraordinaria precisión en generación y validación de código:
ollama run qwen2.5-coder:3b
Paso 4: Conectar Agentes en Python o n8n
Ollama expone de forma predeterminada su API compatible con OpenAI en el puerto local http://localhost:11434/v1. Para que tus scripts de subagentes interactúen con el modelo, basta con apuntar el cliente estándar:
from openai import OpenAI

client = OpenAI(
    base_url=\"http://localhost:11434/v1\",
    api_key=\"ollama\",  # Parámetro requerido aunque no se use clave
)

response = client.chat.completions.create(
    model=\"qwen2.5-coder:3b\",
    messages=[{\"role\": \"user\", \"content\": \"Extrae los campos en formato JSON\"}],
)
print(response.choices[0].message.content)
Preguntas Frecuentes sobre Servidores de IA con Raspberry Pi
¿Cuánta memoria RAM es necesaria para ejecutar agentes en Raspberry Pi 5?
El modelo imprescindible es el de 8 GB de RAM. Aunque existe una versión de 4 GB, el sistema operativo, los servicios de red y los buffers de memoria consumen entre 1 y 1.5 GB, dejando apenas 2.5 GB libres para el modelo LLM. Con 8 GB puedes alojar holgadamente modelos de 3B y 7B parámetros junto con Docker o n8n sin riesgo de bloqueo por Out of Memory (OOM).
¿Qué velocidad de inferencia (tokens por segundo) se obtiene en local?
Con modelos compactos cuantizados en Q4 (como Qwen 2.5 Coder 3B o Llama 3.2 3B), la Raspberry Pi 5 entrega entre 12 y 14 tokens por segundo, una velocidad comparable a la lectura de un ser humano. Con modelos más pesados de 8B parámetros la velocidad desciende a 3.5 - 4 tokens/segundo, adecuada para procesos batch nocturnos pero lenta para chat interactivo.
¿Merece la pena frente a un Mini PC x86 para inferencia continua?
Si tu objetivo es la máxima economía energética y tareas de soporte automatizado (clasificación, filtrado, subagentes ligeros), la Raspberry Pi 5 es imbatible por consumo (menos de 1,50 €/mes de electricidad). Si necesitas inferencia rápida con modelos de 14B o 32B parámetros, un Mini PC x86 con procesador Ryzen y 16 o 32 GB de RAM proporcionará mayor versatilidad a cambio de un consumo ligeramente superior (15W a 30W).
5. Optimización Avanzada: ZRAM, Swap en NVMe y Docker
Para exprimir los 8 GB de la Raspberry Pi 5 sin sufrir bloqueos del kernel ante picos de contexto largo (por ejemplo, ventanas de más de 8.192 tokens en Ollama), aplica estas tres configuraciones en /etc/sysctl.conf:
- Activar ZRAM con Algoritmo lz4: Comprime las páginas de memoria en RAM a alta velocidad antes de recurrir al disco, aumentando virtualmente la capacidad efectiva de memoria a casi 12 GB para procesos de inferencia.
- Evitar Swap en MicroSD: Si el sistema necesita volcar memoria temporal, debe hacerlo obligatoriamente sobre el disco NVMe M.2. Una partición swap en microSD degradará la velocidad en más de un 95% y arruinará la tarjeta en pocos meses.
- Límite de Memoria en Contenedores Docker: Si ejecutas n8n o ChromaDB en contenedores junto a Ollama, establece un techo estricto con
--memory="1.5g"para garantizar que el modelo de lenguaje disponga siempre de al menos 5.5 GB de RAM exclusiva.